RQI y FZI en Python: Líneas Promedio para Agrupar Datos de Núcleos
Porosidad, permeabilidad y grupos exploratorios de calidad de flujo
Yacimientos
Petrofísica
Python
Calcula RQI, porosidad normalizada y FZI con datos de núcleos. Agrupa valores de log(FZI), obtiene líneas de FZI promedio y visualiza su relación con la porosidad y la permeabilidad en Python.
Dos muestras con porosidad similar pueden tener permeabilidades muy distintas. Los índices RQI y FZI permiten analizar esa variación y organizar muestras con características de flujo semejantes.
Seguiremos el procedimiento de unidades hidráulicas de flujo del capítulo 4 de Reservoir Engineering Handbook, quinta edición, de Tarek Ahmed: calcular los índices, representar RQI contra porosidad normalizada y trazar líneas de FZI característico. Para generar grupos de forma reproducible añadiremos una agrupación numérica sencilla en Python.
Trabajaremos con 406 muestras de núcleos de dos pozos, identificados como WELL_1 y WELL_2. La identificación de grupos será exploratoria: el número de unidades hidráulicas de flujo debe contrastarse con información geológica y petrofísica.
Visita el canal @rigopetrodata
Tutoriales de R, Python y Excel para ingeniería petrolera
El índice de calidad del yacimiento se calcula como:
\[
RQI=0.0314\sqrt{\frac{k}{\phi}}
\]
La relación entre volumen de poros y volumen de granos es:
\[
\phi_z=\frac{\phi}{1-\phi}
\]
Y el indicador de zona de flujo es:
\[
FZI=\frac{RQI}{\phi_z}
\]
Usamos k en mD y φ como fracción. Con esas unidades, RQI y FZI se expresan en µm y φz es adimensional. RQI es un índice asociado a la geometría porosa, no una medición directa del radio de garganta de cada muestra.
Por ello, un FZI constante genera una recta de pendiente uno en coordenadas logarítmicas. Diferentes valores generan rectas paralelas. Su inclinación visual solo será de 45° si ambos ejes tienen la misma escala gráfica por década.
Guarda el CSV en la carpeta de tu cuaderno. Contiene las columnas WELL, MD, POROSITY y PERMEABILITY. Para este cálculo utilizaremos la porosidad, ya expresada como fracción, y la permeabilidad en mD. Conservamos el identificador de pozo y la profundidad para posteriores revisiones.
Necesitamos NumPy, pandas, Matplotlib y SciPy. Puedes instalarlos con pip install numpy pandas matplotlib scipy en la terminal. Ejecuta los fragmentos en orden.
Ver código
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy.cluster.vq import kmeans2datos = pd.read_csv("Core_data.csv")validos = (datos["POROSITY"].between(0, 1, inclusive="neither")& (datos["PERMEABILITY"] >0)& np.isfinite(datos["PERMEABILITY"]))print(f"Muestras válidas: {validos.sum()} de {len(datos)}")datos = datos.loc[validos].copy()datos.head()
Muestras válidas: 406 de 406
WELL
MD
POROSITY
PERMEABILITY
0
WELL_1
4038.350098
0.201
1973.9240
1
WELL_1
4038.850098
0.203
1158.9270
2
WELL_1
4039.350098
0.207
1935.1169
3
WELL_1
4039.850098
0.206
1003.6810
4
WELL_1
4040.350098
0.190
901.4980
Las 406 muestras son válidas para las ecuaciones. Los valores de porosidad van de 0.017 a 0.282 y la permeabilidad de 0.002 a 15,913.97 mD. Un valor cero o negativo no puede utilizarse en este análisis logarítmico.
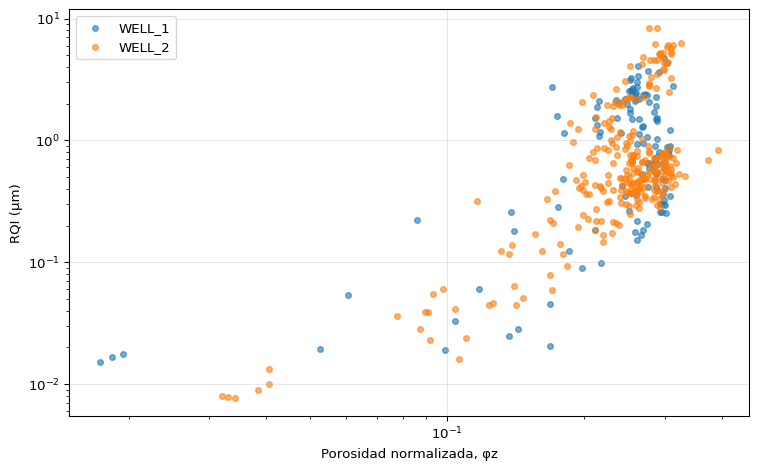
Antes de agrupar, representamos los puntos por pozo. Ambos ejes son logarítmicos.
Ver código
plt.figure(figsize=(8, 5))for pozo, grupo in datos.groupby("WELL"): plt.scatter(grupo["PHIZ"], grupo["RQI"], s=18, alpha=0.6, label=pozo)plt.xscale("log")plt.yscale("log")plt.xlabel("Porosidad normalizada, φz")plt.ylabel("RQI (µm)")plt.grid(alpha=0.3)plt.legend()plt.tight_layout()plt.show()
Figura 1: Distribución de las muestras de los dos pozos en el espacio RQI–φz.
Una muestra situada más arriba que otra con el mismo φz tiene mayor RQI y FZI. La dispersión ayuda a visualizar la variabilidad, pero no determina por sí sola cuántas unidades de flujo existen.
4. Crear cinco grupos exploratorios
Para este primer ejercicio elegimos cinco grupos y aplicamos k-means únicamente a log10(FZI). Es una decisión de trabajo que podemos modificar en n_grupos, no un número de unidades demostrado por los datos ni una regla del método.
Agrupar en log(FZI) utiliza diferencias relativas y es coherente con la gráfica log–log. No incorporamos el pozo o la profundidad al algoritmo. Esta etapa numérica complementa el procedimiento gráfico del libro.
Numeramos los grupos de menor a mayor FZI. La semilla fija hace reproducible esta inicialización. K-means impone el número solicitado y puede depender de la inicialización: sus etiquetas son candidatos para revisión, no una validación de HFU.
5. Obtener el FZI promedio de cada grupo
Para ajustar una línea de pendiente uno en escala logarítmica calculamos:
Este resultado es la media geométrica, que minimiza la suma de residuos cuadrados verticales en log(RQI) con pendiente fija igual a uno y el mismo peso para cada muestra. No es la media aritmética. Esta elección concreta cómo calcularemos el promedio para las líneas del ejemplo.
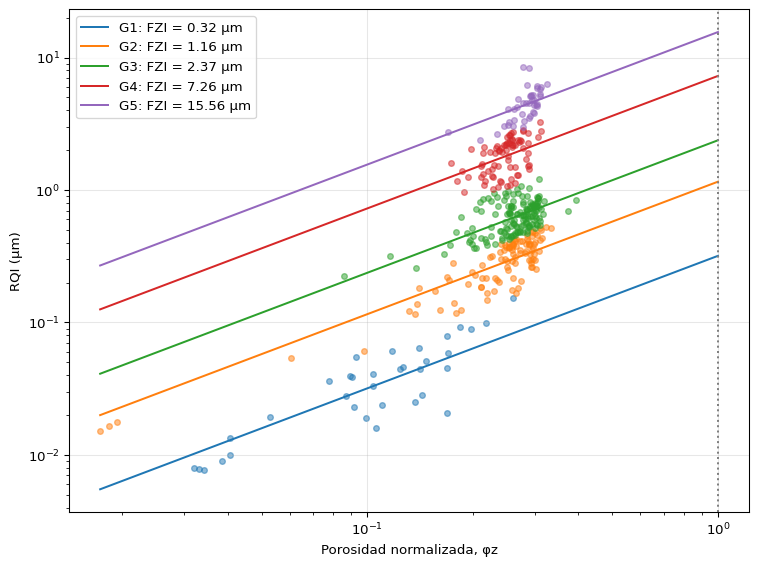
Cada grupo comparte color con su línea. Extendemos las líneas hasta φz = 1, donde RQI toma el valor del FZI promedio. Esa extensión permite leer la intersección y no implica que existan muestras hasta ese punto.
Figura 2: Muestras agrupadas y líneas de FZI promedio geométrico. Las líneas se extienden hasta φz = 1 para visualizar su intersección.
Los puntos no caen exactamente sobre las líneas porque cada grupo contiene un intervalo de FZI. La línea resume su posición central en escala logarítmica.
La agrupación usa el propio FZI, por lo que la cercanía de los puntos a las líneas es parte del criterio de clasificación. No debe interpretarse como una prueba independiente de que hay cinco unidades hidráulicas.
7. Visualizar las curvas equivalentes de permeabilidad
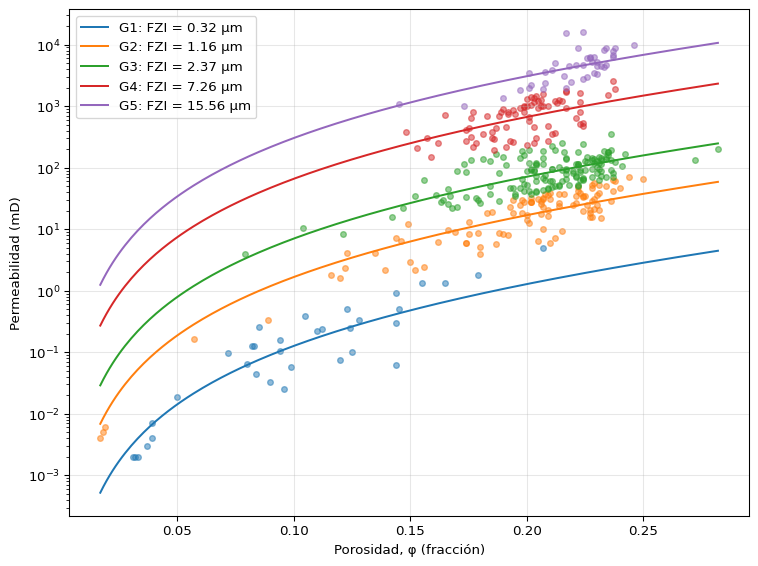
Podemos regresar al espacio porosidad–permeabilidad despejando k:
El libro expresa el coeficiente como aproximadamente 1014. Aquí conservamos \(1/0.0314^2\) para mantener la consistencia con el cálculo inicial de RQI. En este gráfico semilogarítmico aparecen curvas, aunque en RQI–φz las líneas sean rectas.
Figura 3: Curvas de permeabilidad para los mismos cinco valores de FZI promedio, sobre los datos de núcleos.
Interpretación y siguiente paso
El grupo 1 tiene el menor FZI característico y el grupo 5, el mayor. A una misma porosidad, un FZI mayor corresponde a mayor permeabilidad. Esto describe calidad de flujo dentro del modelo, no asigna automáticamente una litología.
Para evaluar si los grupos representan HFU, revisa su distribución por pozo y profundidad y su relación con facies, textura y mediciones de presión capilar. También conviene comparar diferentes números de grupos e inicializaciones y comprobar si las conclusiones se mantienen.
La permeabilidad calculada con el FZI individual reproduce la entrada por identidad algebraica. La curva promedio resume cada grupo; para usarla como predictor en otras muestras se necesita validar la clasificación y la estimación con datos independientes.
Referencia
Ahmed, T. Reservoir Engineering Handbook, quinta edición. Capítulo 4, Fundamentals of Rock Properties, sección Hydraulic Flow Units (HFU), ecuaciones 4-91 a 4-94 y ejemplo 4-32, páginas impresas 269–274.