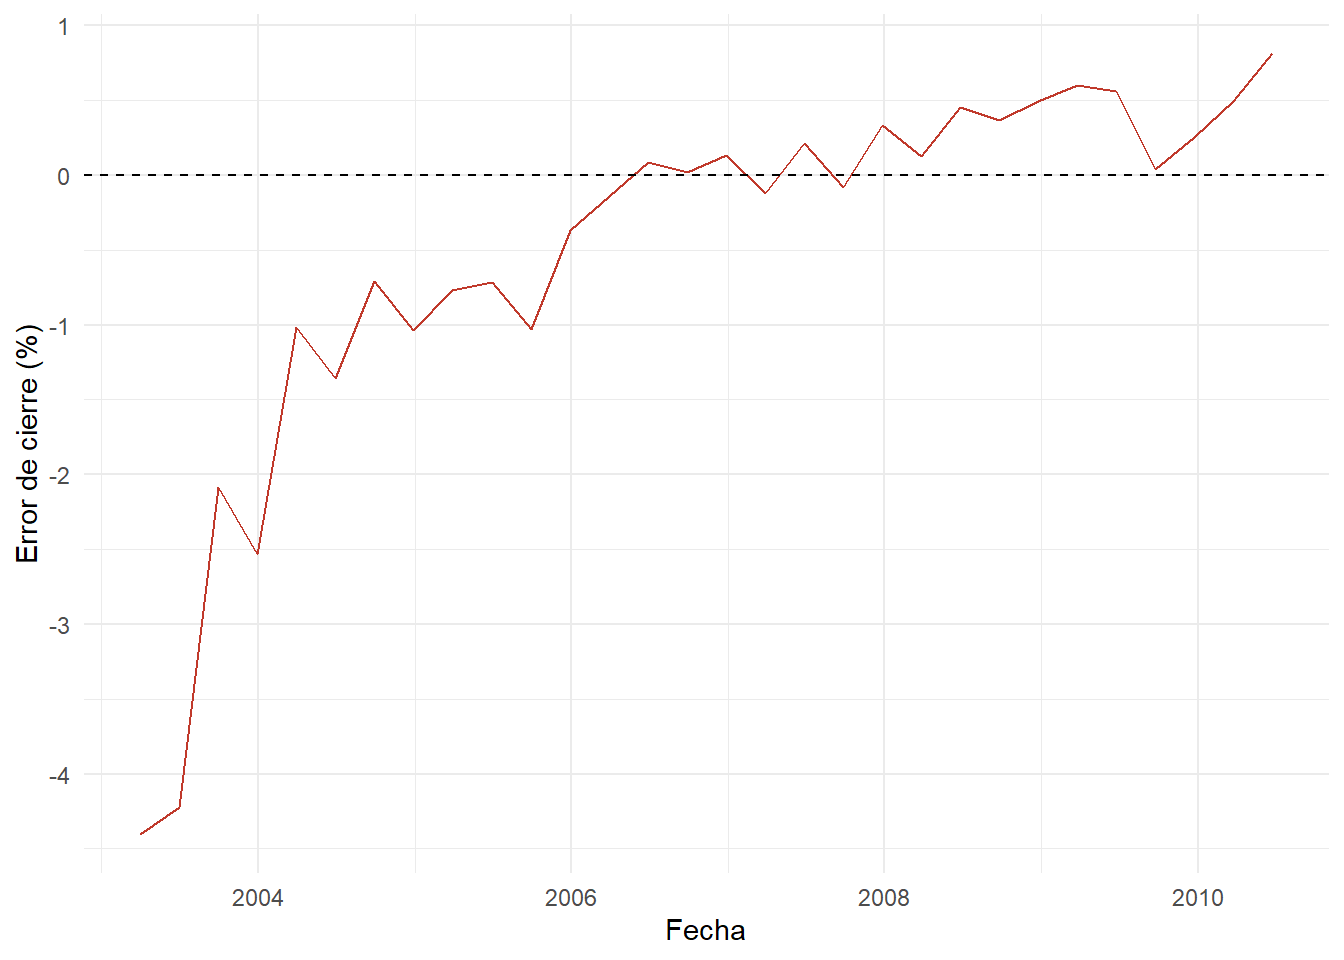Balance de Materia: Ajuste de Np y Verificación de Índices de Empuje
Parte 2: Simulación de la producción acumulada mediante mínimos cuadrados por el origen y validación del mecanismo de empuje
Yacimientos
MBE
Python
R
Segunda parte del balance de materia para yacimientos de aceite. Simulamos Np a partir de un valor de N obtenido por Havlena-Odeh o Campbell, lo ajustamos con mínimos cuadrados lineales para comparar contra el historial de producción, y examinamos los índices y el cierre del balance dominante con los índices de empuje.
En la Parte 1 usamos el método de Havlena-Odeh para estimar el OOIP (N) a partir de la pendiente de F vs Et. Ese valor de N es un buen punto de partida, pero no siempre reproduce con precisión la producción acumulada histórica (\(N_p\)).
En esta segunda parte damos un paso adicional:
Simular \(N_p\) con el N obtenido previamente (ej. de Havlena-Odeh o Campbell)
Comparar contra el \(N_p\) real y detectar desviaciones
Ajustar N con mínimos cuadrados lineales por el origen, porque Np es lineal en N si PVT, presión y Rp están fijados
Recalcular los índices de empuje con el N ajustado y verificar el mecanismo dominante
¿Por qué ajustar Np?
El gráfico de Havlena-Odeh es sensible a la dispersión de los primeros puntos y a errores de medición. Simular Np con el N estimado y compararlo contra el histórico real es una prueba de consistencia adicional — si Np calculado se aleja del observado, especialmente en etapas avanzadas de depleción, se deben revisar N y los supuestos. La desviación también puede proceder de PVT, presión promedio, producción o un mecanismo omitido.
La Ecuación de Np
Para un yacimiento sin acuífero (\(W_e = 0\)) y sin casquete de gas (\(m = 0\)), despejando \(N_p\) de la MBE:
Esta ecuación reconstruye \(N_p\) condicionado a la presión, PVT y \(R_p\) históricos. No es un pronóstico independiente: \(R_p=G_p/N_p\) procede del historial y no es el GOR instantáneo. Este ejemplo no incluye producción de agua; si existiera, habría que incorporar \(W_p B_w\).
Datos del Ejemplo
Usamos el mismo CSV de la Parte 1. Sus unidades son: Np en MMSTB, Gp en \(10^9\) scf, Rs y Rp en Mscf/STB y Bg en RB/Mscf; M=\(10^3\), MM=\(10^6\). Por tanto, \((R_p-R_s)B_g\) es RB/STB. Se conserva el redondeo de las columnas publicado en el CSV. La presión es la promedio del yacimiento, no pwf.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltdf = pd.read_csv("MB_ex.csv", parse_dates=["Date"], dayfirst=True)# === PROPIEDADES DE REFERENCIA (primer registro) ===Boi = df["Bo"].iloc[0]Rsi = df["Rs"].iloc[0]Pi = df["Pavg"].iloc[0]# === PARÁMETROS DE ROCA Y AGUA ===Swc =0.15cf =3.5e-6cw =7.0e-6print(f"Registros: {len(df)}")
Registros: 31
Ver código
print(f"Boi = {Boi}, Rsi = {Rsi}, Pi = {Pi} psia")
Boi = 1.376, Rsi = 0.8, Pi = 5200.0 psia
Ver código
print(f"Rango de fechas: {df['Date'].min().date()} a {df['Date'].max().date()}")
Rango de fechas: 2003-01-01 a 2010-06-23
Ver código
library(dplyr)
Warning: package 'dplyr' was built under R version 4.3.3
Attaching package: 'dplyr'
The following objects are masked from 'package:stats':

    filter, lag
The following objects are masked from 'package:base':

    intersect, setdiff, setequal, union
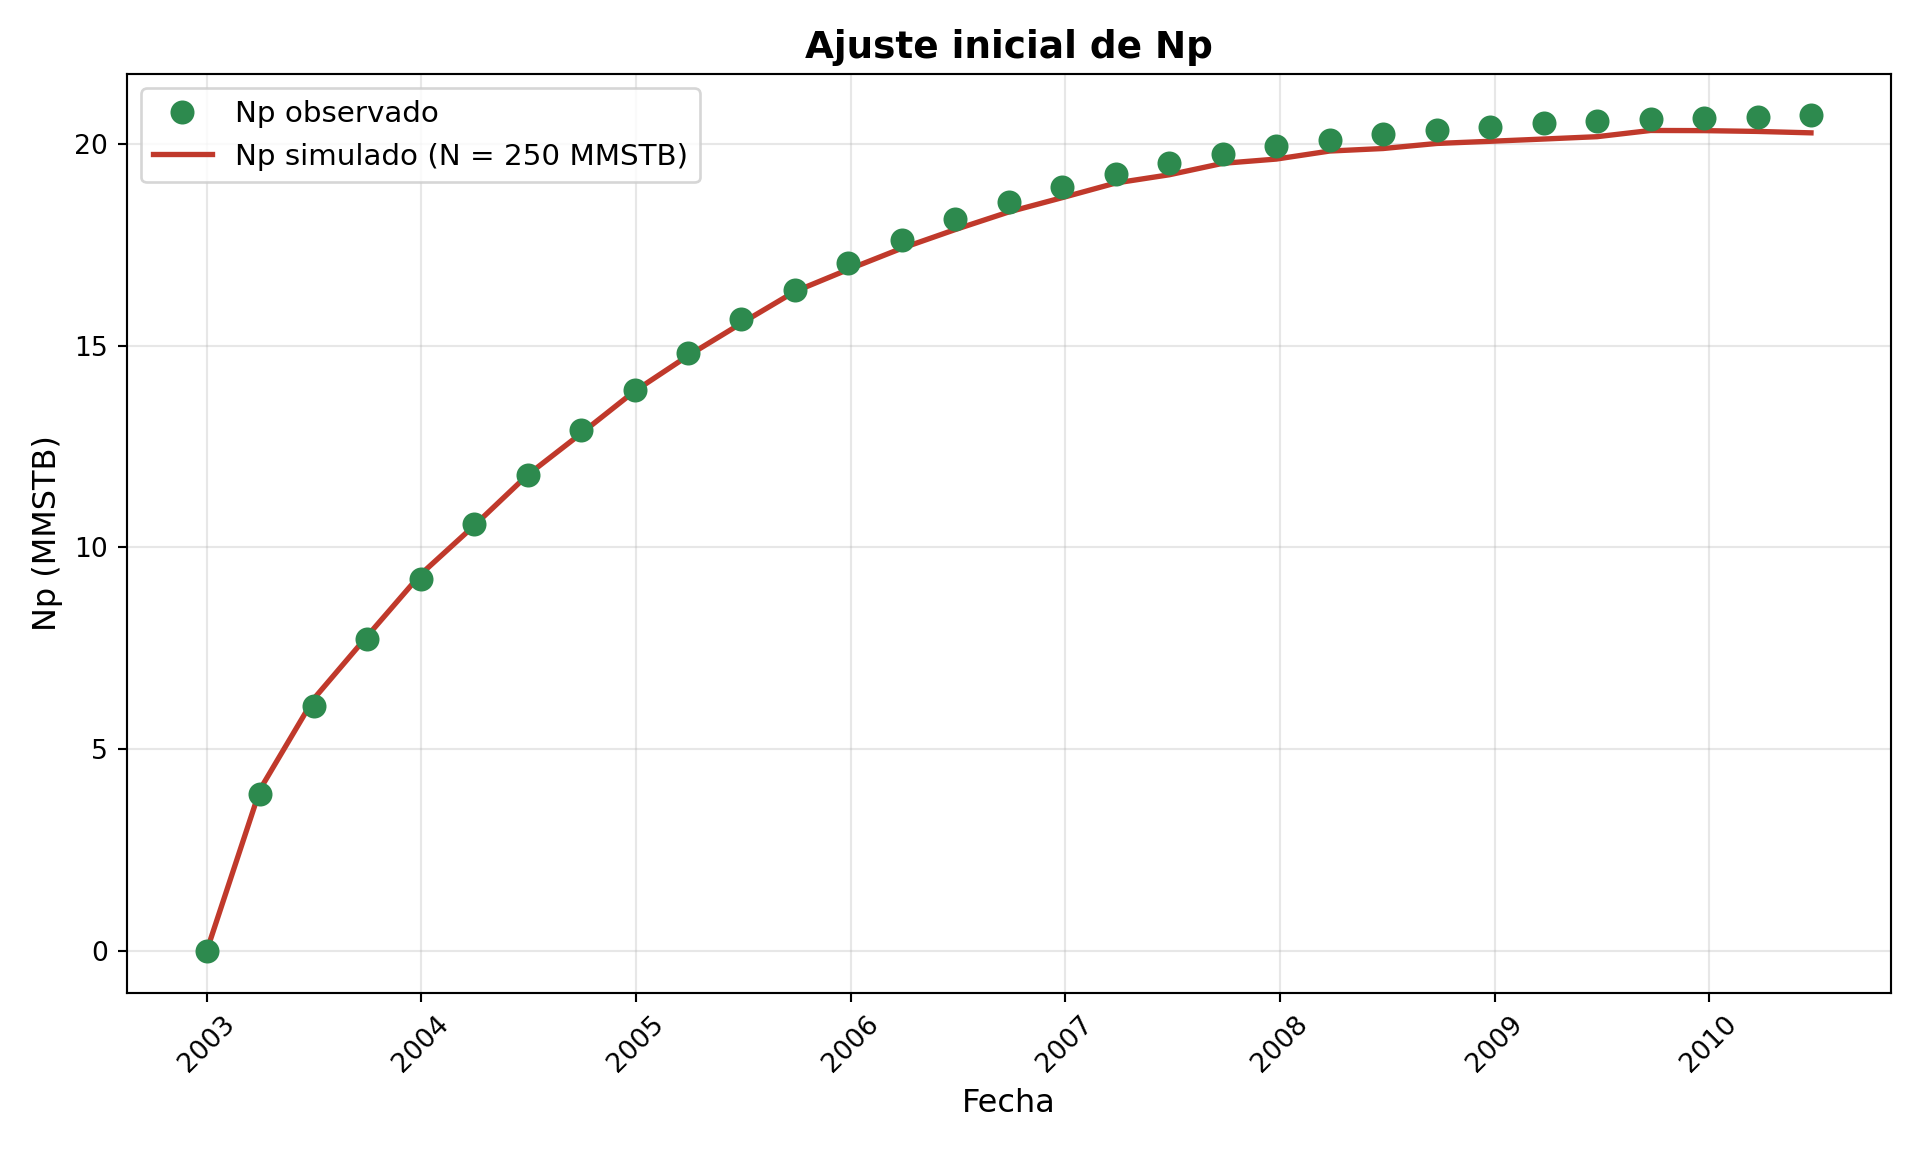
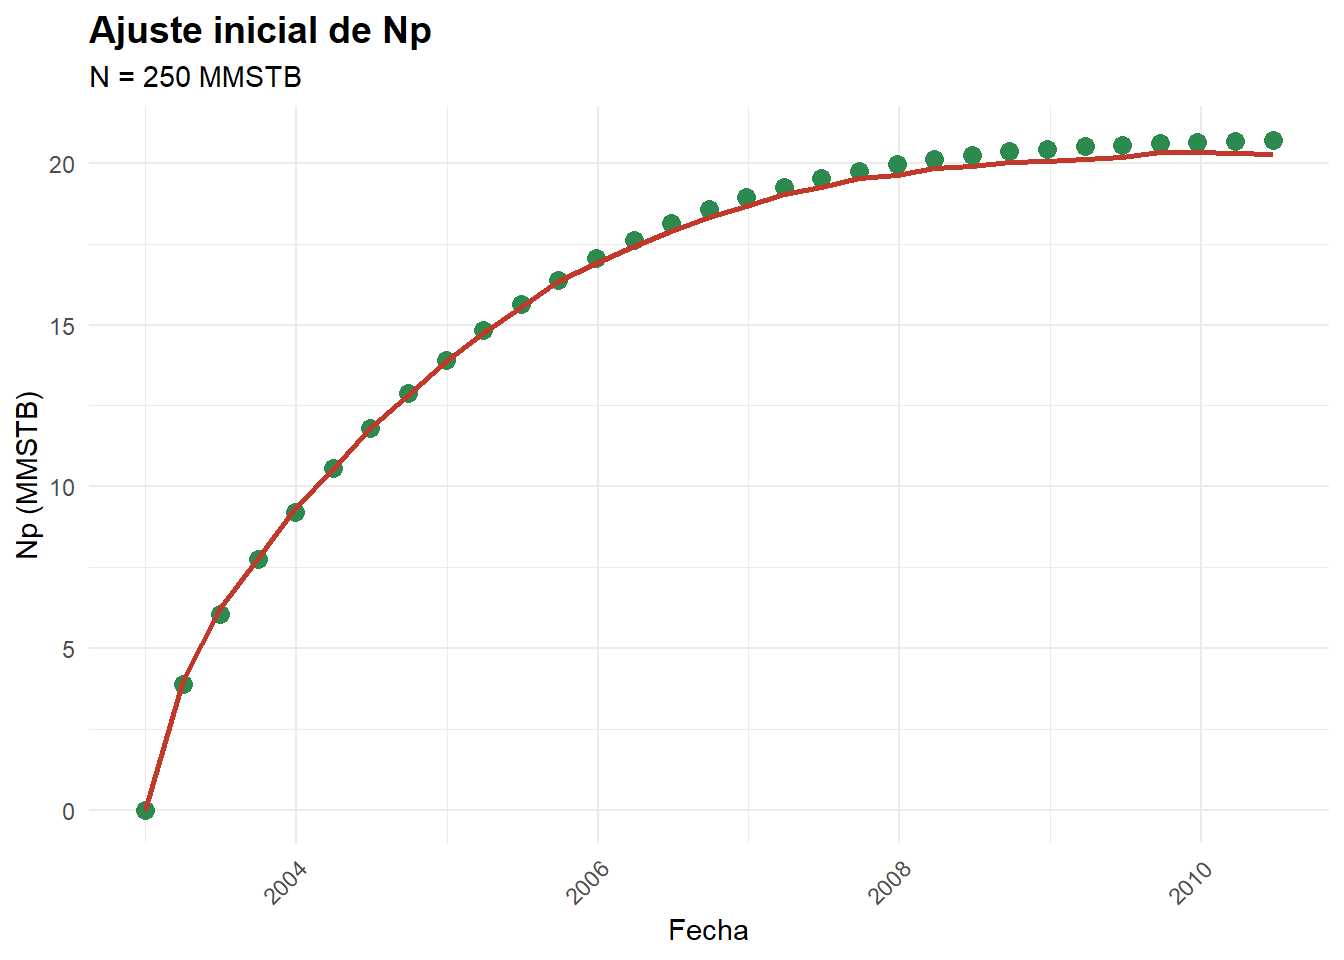
Figure 2: Np observado vs Np simulado con N = 250 MMSTB.
Interpretación
Si la reconstrucción se separa del histórico, revisa los datos y el modelo antes de atribuir toda la diferencia a N. El siguiente paso cuantifica el ajuste. Minimizar errores de Np no equivale a minimizar errores de F: son objetivos con ponderaciones distintas.
Paso 2 — Ajuste lineal de N
Con las propiedades e historia fijadas, la ecuación tiene la forma \(N_{p,i}=N a_i\). No hace falta Levenberg–Marquardt para esta única incógnita:
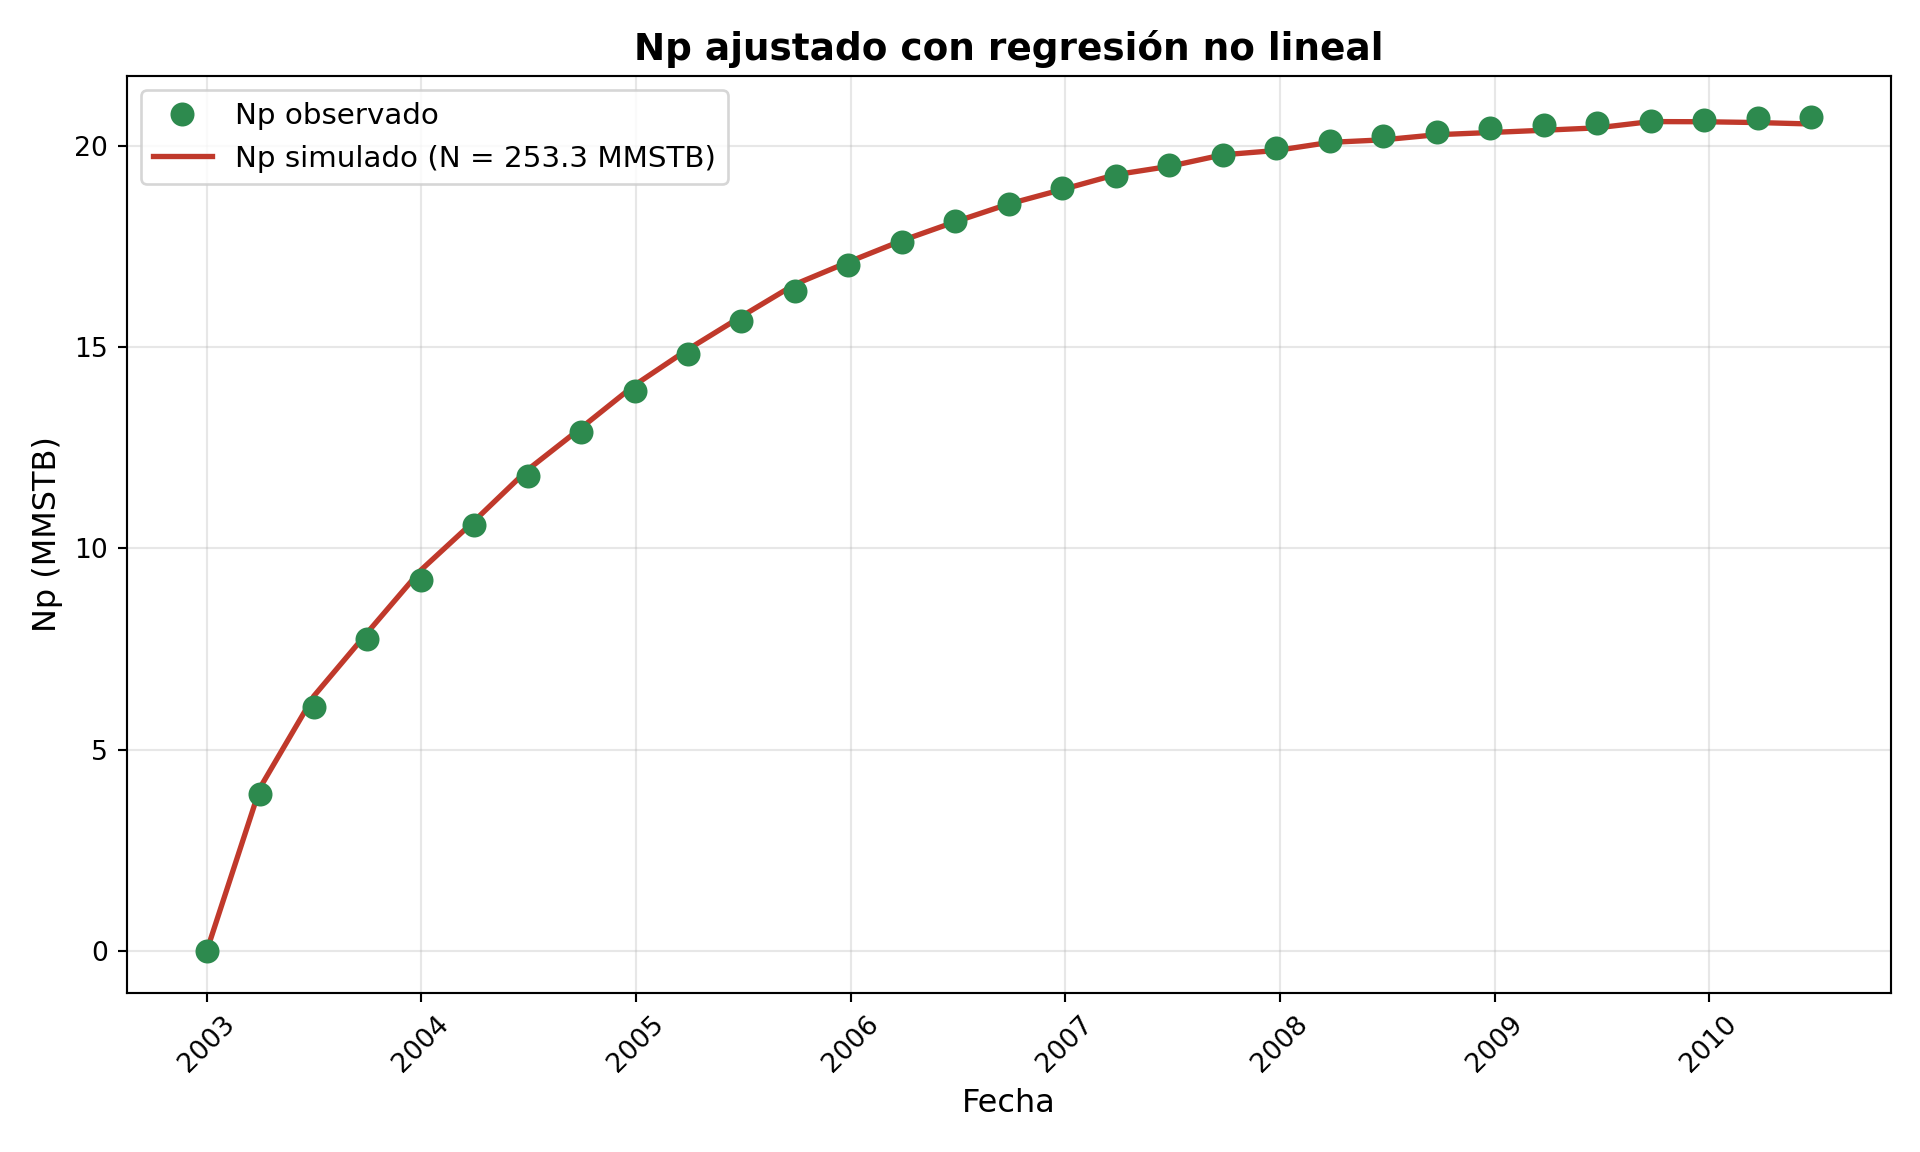
Figure 3: Np observado y reconstruido con mínimos cuadrados lineales por el origen.
Ver código
print(f"N ajustado = {N_fit:.4f} MMSTB")
N ajustado = 253.2646 MMSTB
Ver código
a <-np_calc(1, BM_data)validos <-is.finite(a) &is.finite(BM_data$Np) & a >0N_fit <-sum(a[validos]*BM_data$Np[validos])/sum(a[validos]^2)BM_data$Np_cal <-np_calc(N_fit, BM_data)ggplot(BM_data) +geom_point(aes(Date, Np), color="#2d8a4e", size=3) +geom_line(aes(Date, Np_cal), color="#c0392b", linewidth=1) +labs(x="Fecha", y="Np (MMSTB)", title="Ajuste de N por mínimos cuadrados lineales",subtitle=sprintf("N = %.2f MMSTB", N_fit)) +theme_minimal()cat(sprintf("N ajustado = %.4f MMSTB\n", N_fit))
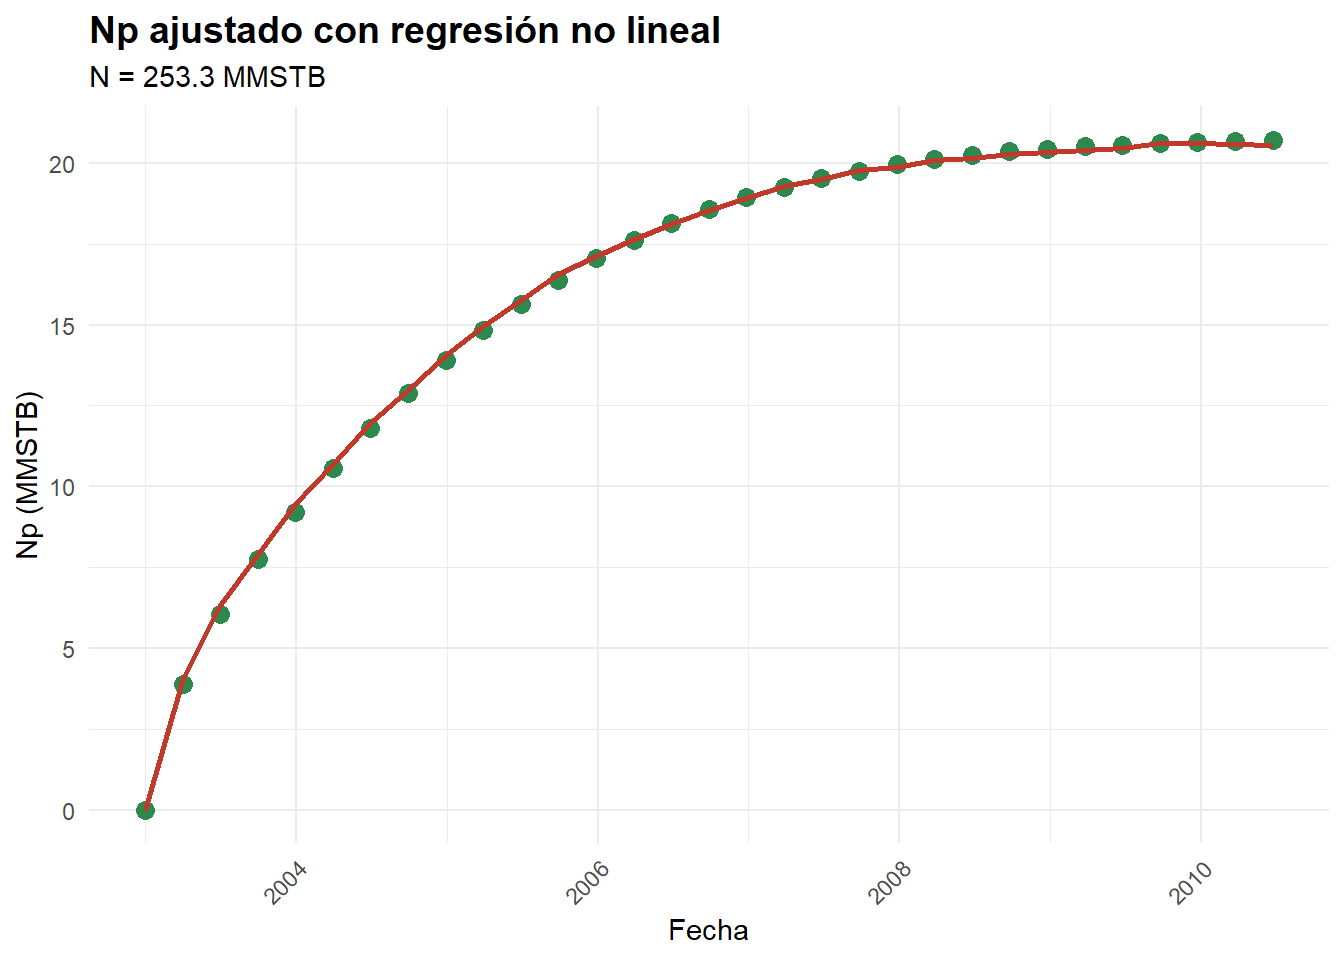
N ajustado = 253.2646 MMSTB
Figure 4: Np observado y reconstruido con mínimos cuadrados lineales por el origen.
Con el CSV publicado, N≈253.26 MMSTB. El ajuste de F frente a Et por el origen de la Parte 1 da aproximadamente 253.76 MMSTB. La diferencia responde al objetivo minimizado; no implica una contradicción entre las ecuaciones.
Paso 3 — Índices de empuje y cierre independiente
Para este caso, sin acuífero, casquete ni producción de agua:
No se define CDI como 1−DDI: eso obligaría a cerrar el balance e impediría verificarlo. El estado inicial, F=0, se excluye de estos cocientes. No se recorta el gráfico a 1, para no ocultar una suma mayor que la unidad.
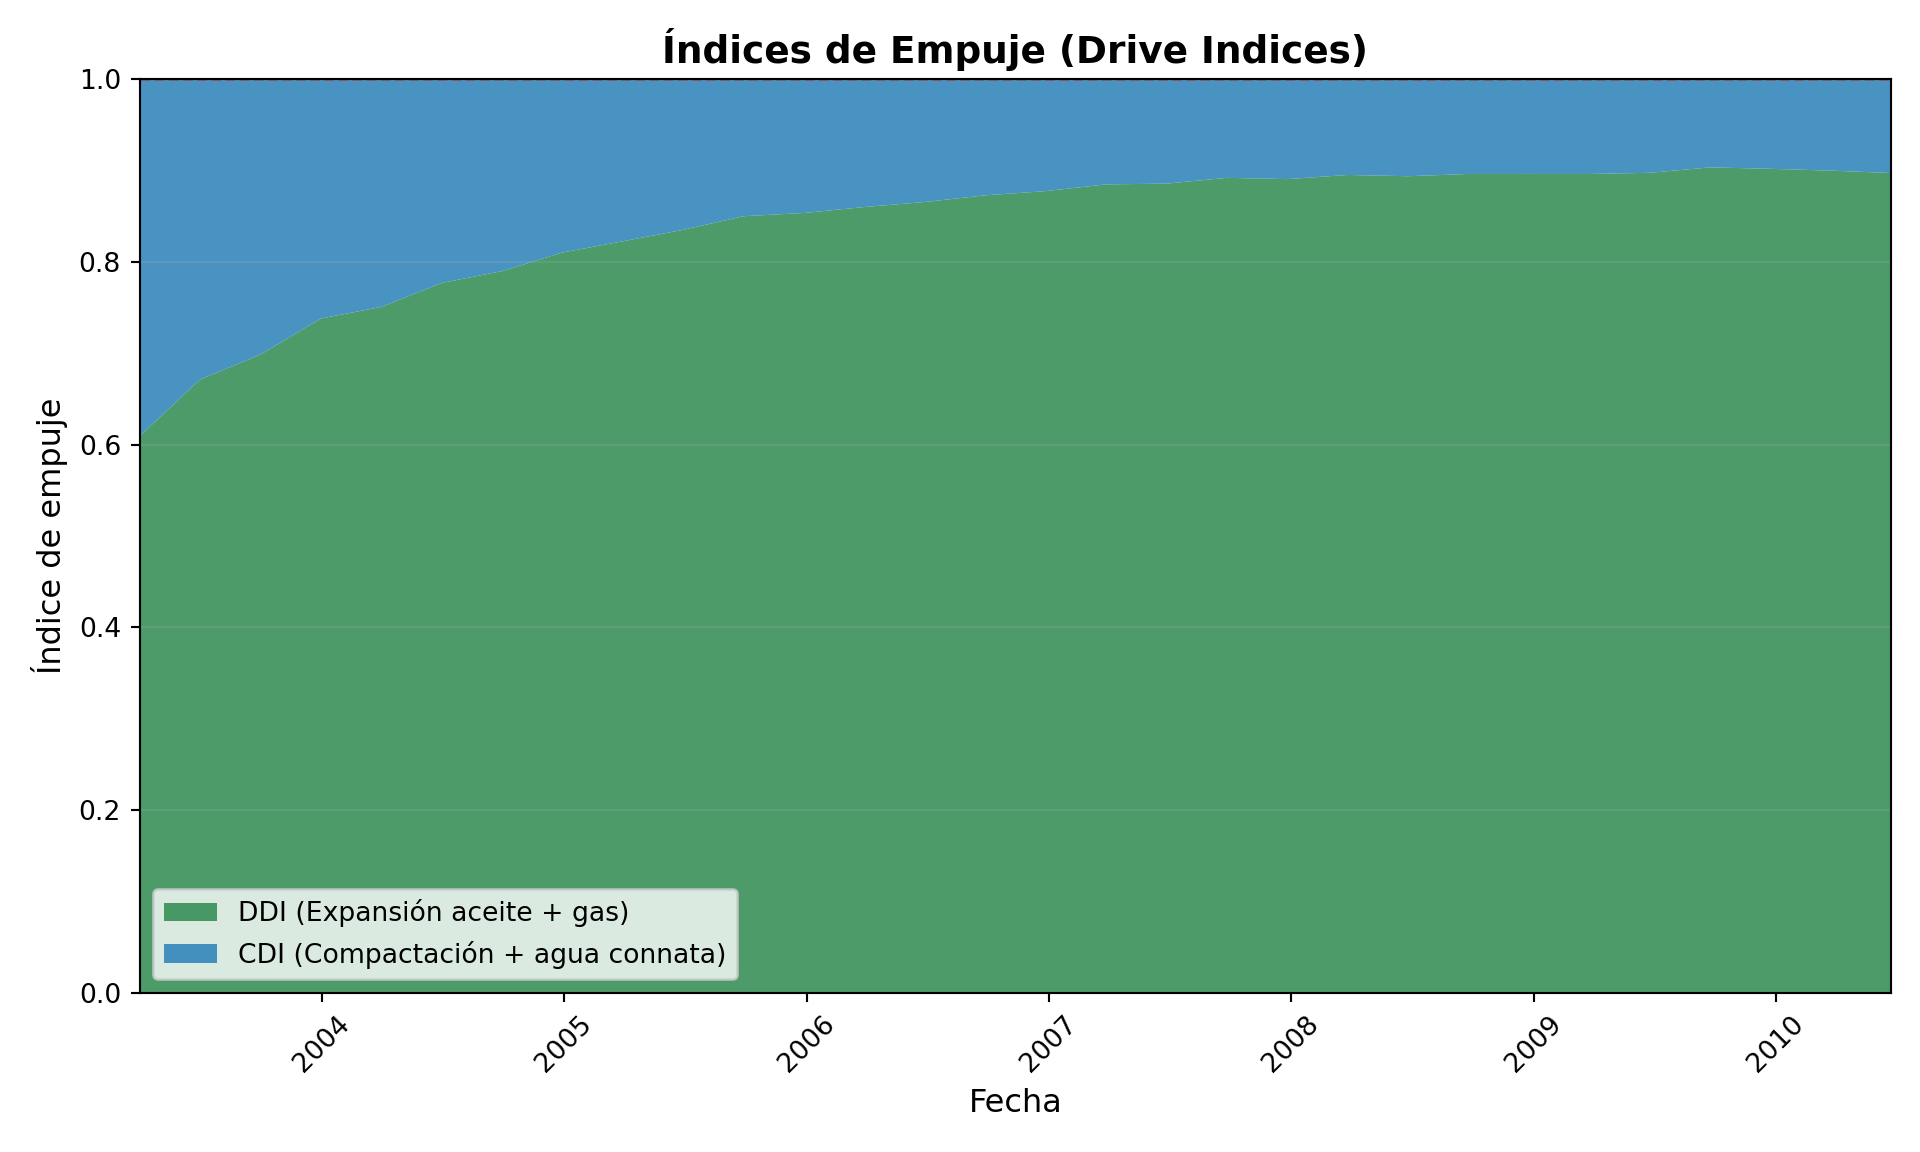
Figure 6: Aportes independientes, sin forzar su suma a uno.
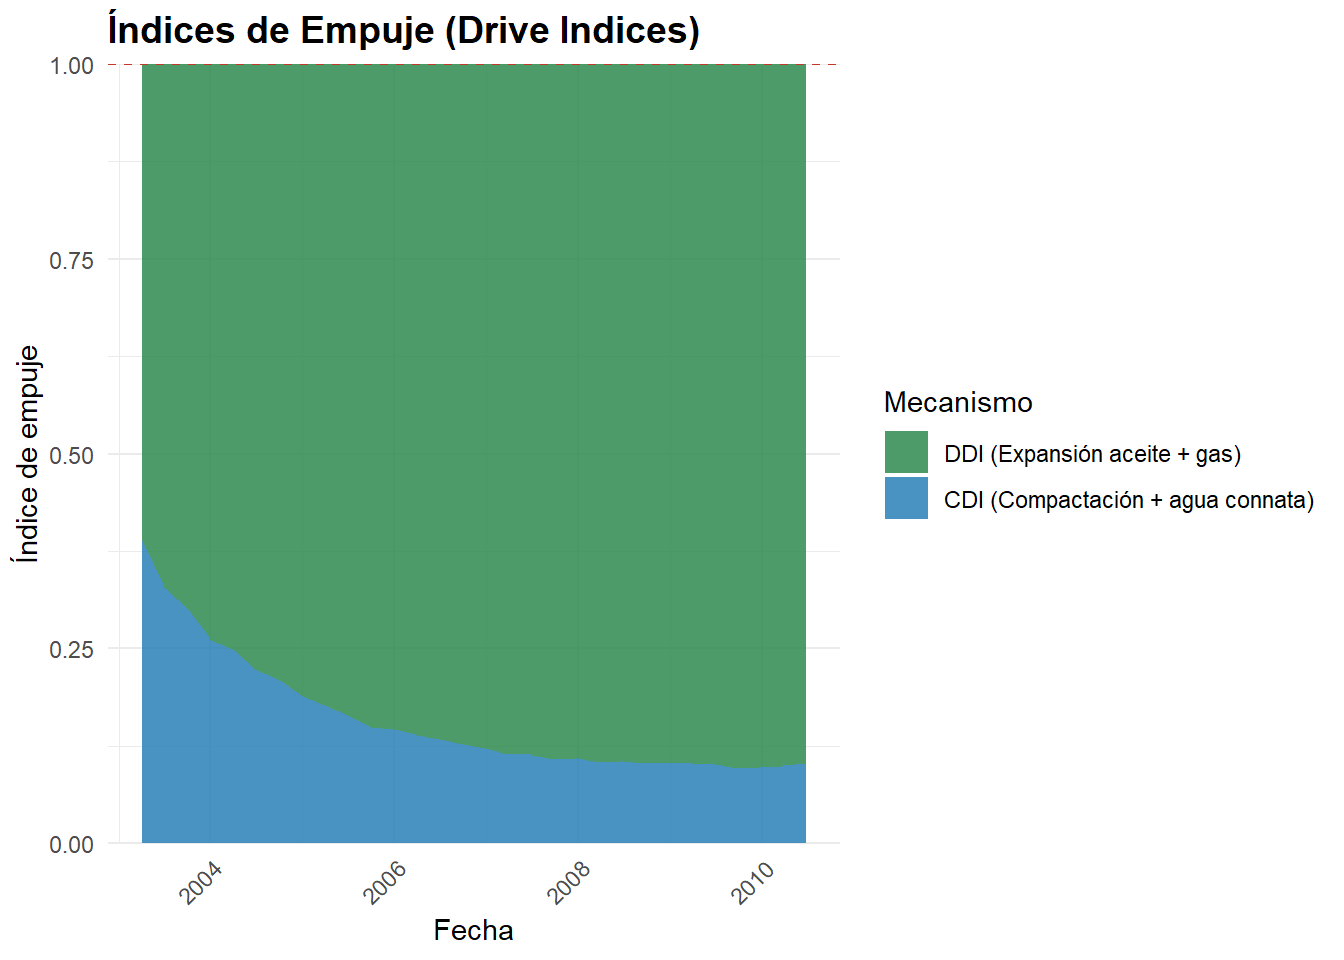
Figure 7: Aportes independientes, sin forzar su suma a uno.
Interpretación de los resultados
Índice
Aporte representado
DDI
Expansión del aceite y del gas originalmente disuelto
CDI
Reducción de volumen poroso y expansión de agua connata
WDI
Entrada de agua, si el modelo incluye un acuífero
SDI
Expansión de casquete inicial, si el modelo lo incluye
No se usan umbrales universales para clasificar un yacimiento. En este historial y con N ajustado, DDI varía aproximadamente de 0.61 a 0.90 y CDI de 0.09 a 0.43. Roca y agua son especialmente relevantes en los primeros registros; no es correcto asignar un CDI de 7–10% a todo el historial.
La suma DDI+CDI varía aproximadamente entre 0.992 y 1.044. El error de cierre, con el signo definido arriba, va de −4.41% a +0.81%. El ajuste es aproximado, no una identidad exacta impuesta al gráfico.
Un cierre cercano a cero respalda consistencia con los datos y supuestos, pero no valida un modelo único. Si falla, deben revisarse presión promedio, PVT, producción, N y posibles mecanismos omitidos. N es petróleo original en sitio y no equivale a reservas recuperables.
Resumen
Resultado
Valor o criterio
N inicial de comparación
250 MMSTB
N ajustado minimizando error de Np
253.26 MMSTB
N ajustado minimizando error de F (Parte 1)
253.76 MMSTB
DDI / CDI
Calculados independientemente, sin normalización
Verificación
Comparación histórica y error de cierre por registro
Referencias
Havlena, D. & Odeh, A.S. (1963). The Material Balance as an Equation of a Straight Line. JPT, 15(8).
Ahmed, T. (2019). Reservoir Engineering Handbook, 5th ed. Gulf Professional Publishing. Cap. 11.
Sanni, M. (2019). Petroleum Engineering: Principles, Calculations, and Workflows. Wiley/AGU.
Dake, L.P. (1978). Fundamentals of Reservoir Engineering. Elsevier. Cap. 3.